1.2.6. 마스터 서버 변경하기
현재까지의 버전으로는, 리플리케이션이 실패하는 경우에 마스터와 슬레이브 간에 장애
복구 (failover)를 공식적으로 할 수 있는 방법은 없다. 우선, 마스터와 슬레이브를 설정한
후에, 마스터 동작을 감시하는 도중에 리플리케이션이 실패하면 어플리케이션과 슬레이브가
마스터를 변경시키는 스크립트를 작성해야 한다.
슬레이브는 CHANGE MASTER TO 명령문을 사용해서 언제든지 자신의 마스터를 변경할
수 있다는 점을 알아두자. 슬레이브는 마스터에 있는 데이터베이스가 자신의 것과 호환성을
가지고 있는지 검사하지 않으며, 단지 지정된 로그와 지정 위치의 이벤트를 새로운 마스터에
서 시작하기만 한다. 장애 복구 상황에서는, 그룹 내 모든 서버가 동일한 바이너리 로그의
동일 이벤트를 실행하기 때문에, 이벤트 소스를 변경해도 데이터베이스 구조 또는 집적도에는
영향을 주지 않는다.
슬레이브 서버 한 대를 --log-bin 옵션으로 구동을 시킨 후에 (--log-slave-updates 옵션은
사용하지 말 것), 다른 슬레이브에서 STOP SLAVE; RESET MASTER, 그리고 CHANGE MASTER
TO 명령문을 실행하면, --log-bin 옵션으로 구동된 슬레이브가 마스터 역할을 수행한다.
아래의 그림 1.4와 같은 구조의 시스템을 가지고 있다고 가정하자.
Figure 1.4. 리프리케이션을 사용하는 리던던시 (Redundancy)
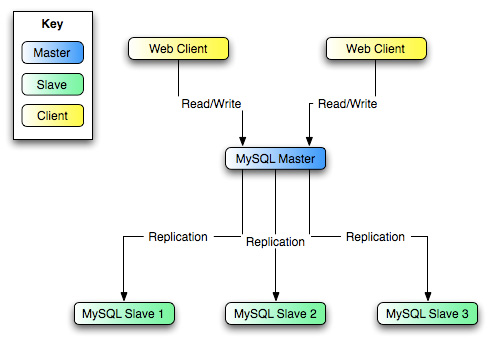
위 그림에서 보면, MySQL Master 서버는 마스터 데이터베이스를 가지고 있고, MySQL Slave 서버는 리플리케이션 슬레이브이며, Web Client 머신은 데이터베이스 읽기 및 쓰기 연산을 실행한다. 읽기 연산만 실행하는 웹 클라이언트는 리플리케이션이 실패하더라도 새로운 서버로 변환될 필요가 없기 때문에 위 그림에서는 표시가 되지 않았다.
각각의 MySQL 슬레이브 (Slave 1, Slave 2, 그리고 Slave 3)는 --log-slave-updates가 아닌 --log-bin를 구동하고 있는 슬레이브이다. 슬레이브가 마스터에서 전달받는 업데이트는 --log-slave-updates가 지정되지 않으면 바이너리 로그에 기록되지 않기 때문에, 각 슬레이브의 바이너리 로그는 초기에 비어 있게 된다. 어떤 이유로 인해 MySQL Master를 사용할 수 없게 된다면, 슬레이브 중의 하나를 새로운 마스터로 할당할 수 있다. 예를 들면, Slave 1을 새로운 마스터로 할당한다면, 모든 Web Clients는 Slave 1을 새로운 마스터로 사용하게 된다. 즉, Slave 2 및 Slave 3는 Slave 1과 리플리케이션을 구현한다.
슬레이브를 --log-slave-updates 상태로 구동 시키는 이유는, 슬레이브 중의 하나를 새로운 마스터로 할당하는 경우에 업데이트를 두 번 받지 않도록 하기 위함이다. Slave 1이 --log-slave-updates 옵션을 활성화 하였다고 가정하자. 이렇게 되면, Slave 1은 Master에서 받은 업데이트를 자신의 바이너리 로그에 기록한다. Slave 2가 자신의 마스터를 Master에서 Slave 1로 변경하게 되면, 이미 Master에서 받았던 업데이트를 Slave 1에서 다시 받게 된다.
모든 슬레이브가 자신의 릴레이 로그에 있는 모든 명령문을 처리했는지 확인한다. 각 슬레이브에서 STOP SLAVE IO_THREAD를 실행한 후에 Has read all relay log가 나올 때까지 SHOW PROCESSLIST 결과를 확인한다. 모든 슬레이브에서 결과를 확인한 후에 새로운 설정을 구성하도록 한다. 새로운 마스터 역할을 하게 되는 Slave 1에서 STOP SLAVE 및 RESET MASTER를 실행한다.
Slave 2 및 Slave 3에서 STOP SLAVE 및 CHANGE MASTER TO MASTER_HOST='Slave1' ('Slave1'은 Slave 1의 실제 호스트 이름을 사용한다)를 실행한다. CHANGE MASTER를 실행하기 위해서는, Slave 2 또는 Slave 3 가 새로운 마스터 Slave 1에 접속하기 위한 모든 정보 (user, password, port)를 추가해야 한다. CHANGE MASTER를 실행할 때에는, Slave 1의 바이너리 로그 이름 또는 바이너리 로그 위치를 지정할 필요가 없다: 그 이유는, 첫 번째 바이너리 로그와 포지션 4가 CHANGE MASTER의 디폴트 값이라는 것을 알고 있기 때문이다. 마지막으로, Slave 2 및 Slave 3에서 START SLAVE를 실행한다.
새로운 리플리케이션을 구동한 후에는, 각 Web Client의 명령문이 Slave 1을 가리키도록 만들어야 한다. 이 시점이 되면, Master가 정지한 이후에 Slave 1에 전달된 것을 포함한 Web Client의 모든 업데이트 명령문이 Slave 1 바이너리 로그에 기록된다.
따라서, 새로운 마스터 설정이 그림 1.5와 같이 구성된다.
Figure 1.5. 마스터 정지 후의 리플리케이션 리던던시
Master가 다시 구동을 하면, Slave 2 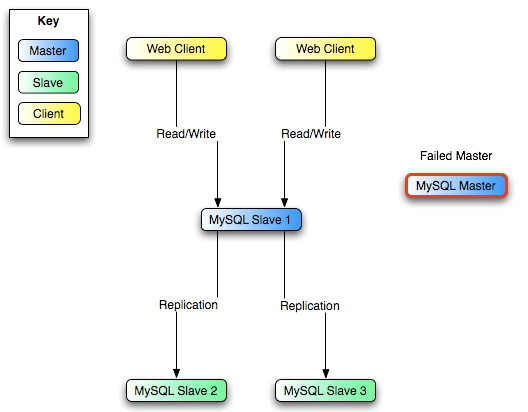
Master가 다시 마스터 서버 역할을 하도록 만들기 위해서는, Slave 1가 더 이상 마스터 서버 역할을 하지 못해서 Master를 새로운 마스터로 설정하는 절차를 진행하면 된다. 이렇게 하기 위해서는, Slave 1, Slave 2, 그리고 Slave 3 서버를 Master의 슬레이브로 구성하기 전에 RESET MASTER를 Master에서 먼저 구동 시켜야 한다는 것을 잊지 말도록 한다. 그렇지 않으면, Master를 사용할 수 없게 된 시점 이전에 기록된 구형 Web Client 쓰기를 슬레이브 서버들이 가져올 수 있기 때문이다.